Continuation of Nicholas Carlini's list, covering arXiv submissions since 2025-09-15.
TF-IDF + logistic regression trained on the original 13,697-entry list (held-out AUC 0.998); papers scoring ≥40% shown, grouped by arXiv ID month.
Total: 3547 papers.
Last update: 2026-11-21.
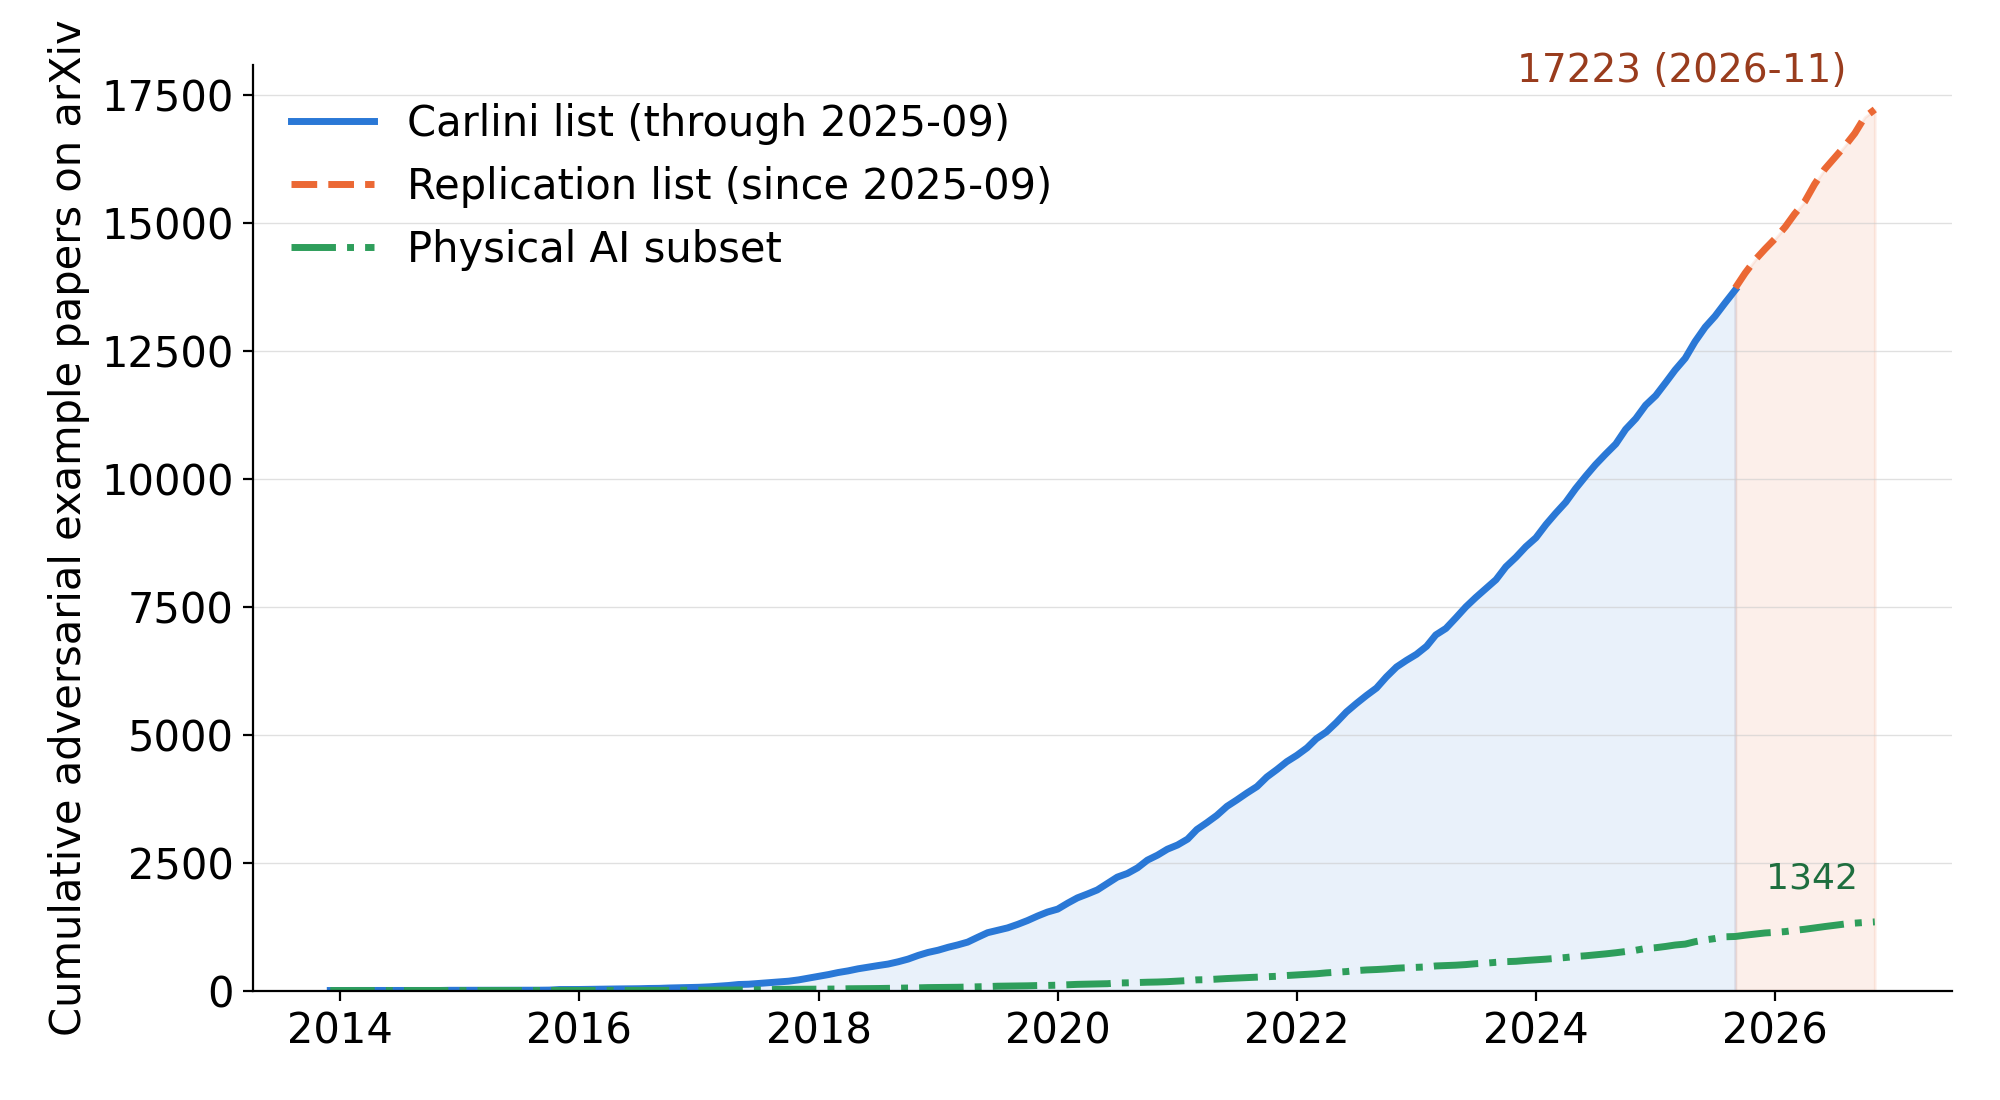
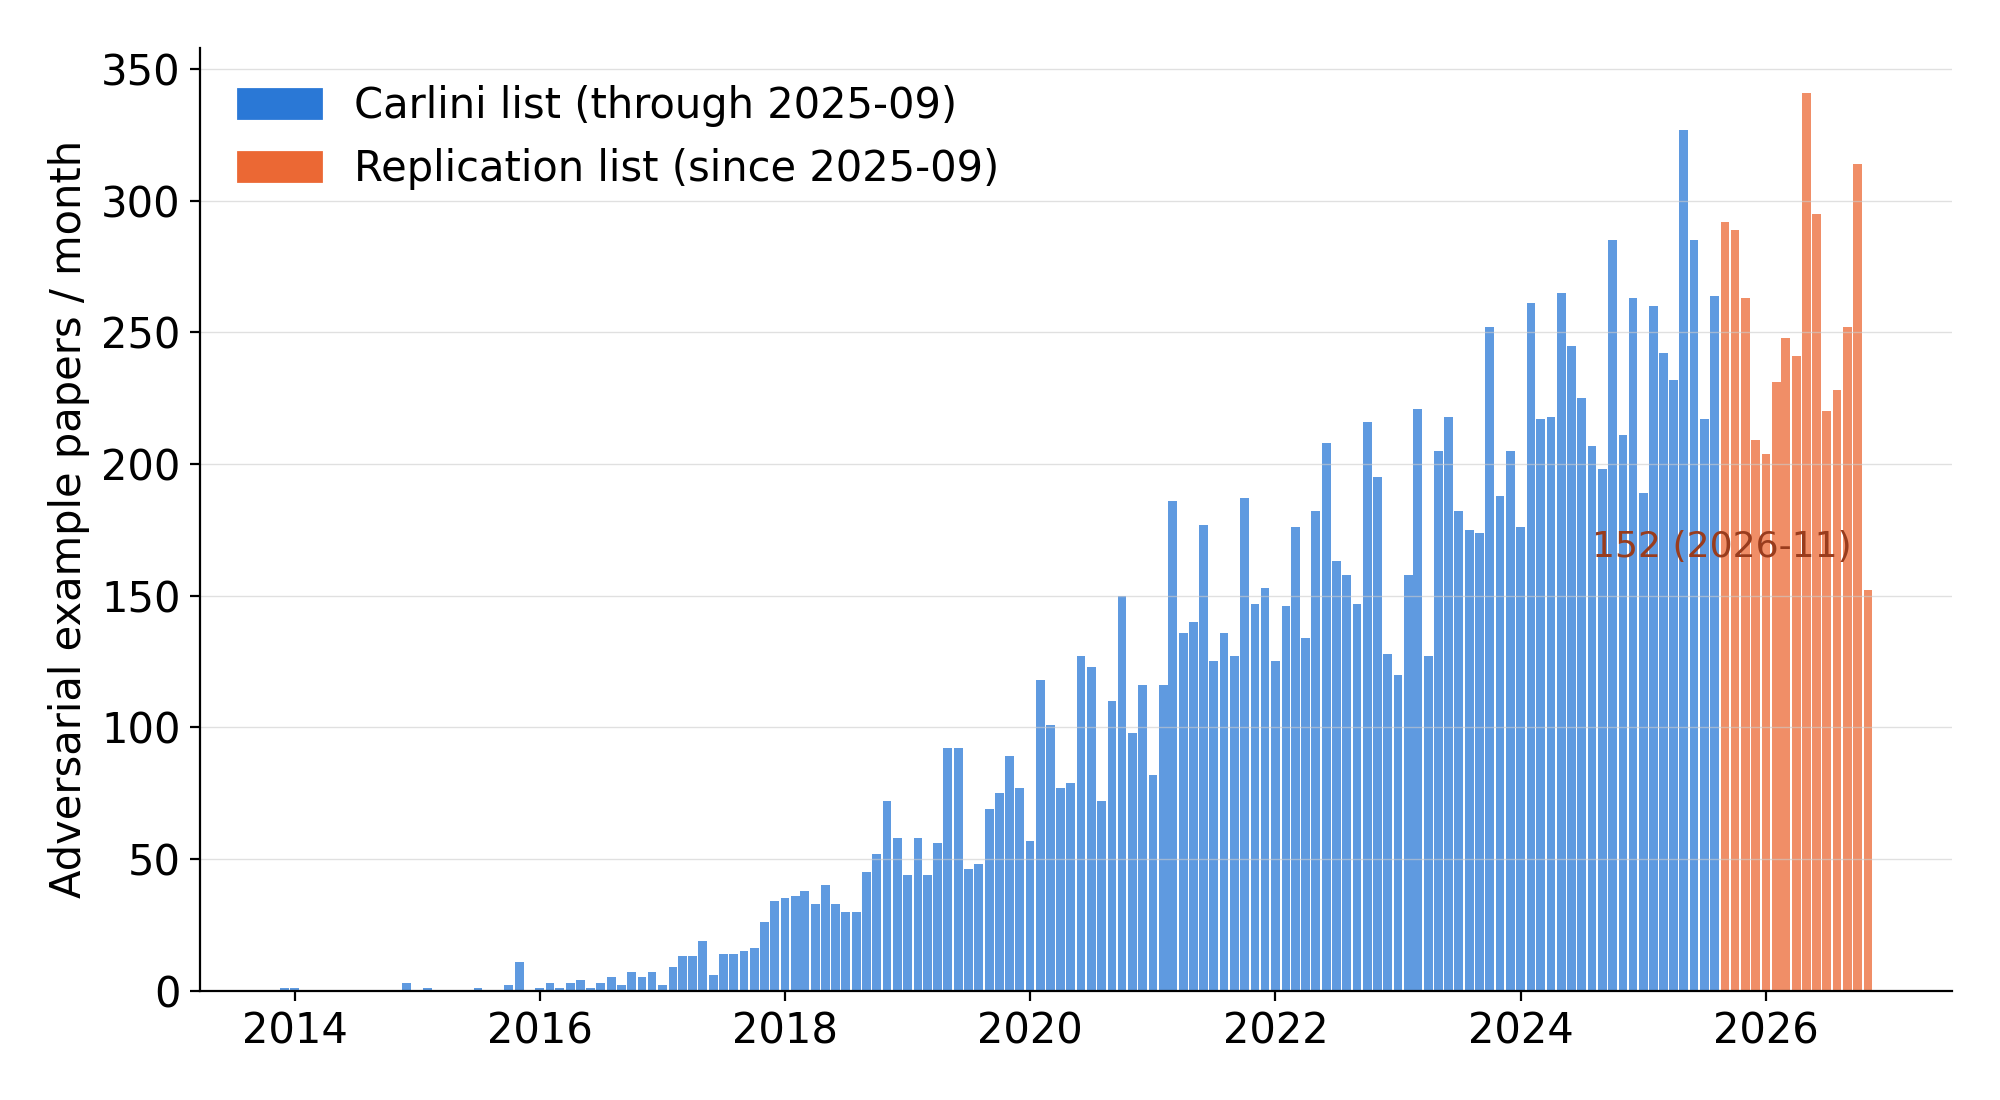
Full list (3547 papers, all months): https://nsl.cs.waseda.ac.jp/papers/advex_papers.html
Download: CSV
Download: CSV
Most recent month
2026-11 (152 papers)
- [100%] Black-Box Adversarial Example Attacks on Machine Learning based Election Systems
Subek Acharya; Syed Ayon; Khaleque Md Aashiq Kamal; Alina Barnett; Surya Eada; Kaleel Mahmood - [100%] Adversarial Robustness of Kernel Machines: A Comprehensive Analysis
Rahul Kumar Yadav; Tunir Ghosh; Sudhendu Ahir; Parthe Pandit; Arjun Bhagoji - [99%] VIPA: View-Invariant Projector-Based Adversarial Attack
Jiyu Han; Qingyue Deng; Bingyao Huang - [99%] Conv-Reluplex: A Verification Framework For Convolution Neural Networks
Jin Xu; Zishan Li; Miaomiao Zhang; Bowen Du - [99%] Learning to Verify: Signature-Guided Training for Adaptive Adversarial Detection
Arash Vashagh; Roozbeh Razavi-Far - [98%] GARD: Gradient-Guided Adversarial Representation Defense against Backdoors in Multimodal Contrastive Learning Models
Yuhong Wang; Yujun Cai; Lei Feng; Songze Li - [98%] Binarization as an Attack Surface in Weightless Neural Networks
Lucas Senos Coutinho; Matheus Vargas; Pedro Teixeira; Heudson Tosta Mirandola; Ori Rottenstreich; Priscila Machado Vieira Lima; Leandro Santiago; Daniel Sadoc Menasche - [98%] Representational Geometry as a Diagnostic for Adversarial Robustness
Brandon Ismalej; Alex Cloninger; Gal Mishne - [98%] Robustness as a Transferable Skill: Cross-Task Adversarial Defense for Vision-Language-Action Policies
Jinquan Zhang; Run Yang; Dongfu Yin; Qiang Lai; Yufeng Yan; Pengshuai Yin; F. Richard Yu - [97%] Structured Confidence Perturbation via Fisher Geometry for Adversarial Training
Chenlong Wei; Hanling Wang; Chong Zhang; Qinkai Yu; Fangyu Wu; Xiaobo Jin - [97%] Poison-then-Hide: Finetuning-Activated Backdoor Attack on Pretrained Vision Encoders
Qixuan Jin; Abinitha Gourabathina; Vinith Menon Suriyakumar; Walter Gerych; Marzyeh Ghassemi - [97%] On the Impact of Feature Reduction Techniques on Adversarial Attacks
Mohammad Meymani; Roozbeh Razavi-Far - [96%] Anchored Rank-Adversarial Fine-Tuning Pretrained Visual Place Recognition Models
Mostafa Kira; Bader Rasheed; Manuel Mazzara - [96%] On Lipschitz Explosion in Deep Neural Networks with Normalization: Consequences for Optimization and Adversarial Robustness
Ashkan Soleymani; Reyhaneh Hosseinpourkhoshkbari; Hadi Daneshmand; Patrick Jaillet - [96%] SmoothShift: Disrupting Visual Adversarial Attacks on LVLMs at Test Time
Xiaoqing Chen; Jiayi Ouyang; Dongrui Wu - [95%] RL-ATTACK: A Generalized Black-Box Adversarial Attack on Language Models via Reinforcement Learning
Taikun Chen; Yue Zhang; Wei Qian; Hui Fang - [95%] Measuring Robustness and Efficiency in a Connectome-Constrained Fly Visual System Model: Linking an Adversarial and a Perceptual Illusion
Alexandre Garcia-Duran; Alejandro Rodriguez-Garcia; Manuel Molano-Mazón; Alexandre Hyafil; Srikanth Ramaswamy; Janne K. Lappalainen - [94%] PIPETTE: Prompt Injection Purple-Teaming for Robust LLM Agents
Lipeng He; Yihan Wang; Jiawen Zhang; N. Asokan - [94%] Density Feedback Control for Transferability of Generative Sparse Adversarial Attacks
Dongsu Song; Jay Hoon Jung - [93%] Robust Deep Prototype Classifiers via Lipschitz Training
Adia Khalid Khan; Lukas Gehring; Benjamin PaaÃen - [93%] AnyBreak: Towards Jailbreaking Any T2I Model for Any Concept
Qi Lu; Zehui Guo; Yucheng Zhao; Zijing Li; Chuhan Song; Wenrui Zhu - [92%] VisualJevBench: A Benchmark and Black-Box Attacks for Visual Typed Decision Models
Li Zeng; Yeqi Zeng; Hengkai Liang; Shiguo Wang; Meng Xie; Zeyu Ye; Jinheng Zhang; Xianlong Wang; Ziqi Zhou; Hangtao Zhang - [91%] Adversarial Robustness Is Not Zero-Day Generalization: A Controlled Evaluation of Flow-Based Intrusion Detectors on Corrected CIC-IDS2017
Abdulhamid Zaro - [91%] Gradient-Based Defensive Poisoning Against System Identification Attacks on Cyber-Physical Systems
Gonçalo Fernandes; José CecÃlio; Victor Mattos; Daniel S. Menasché; Amit Bhaya; Alan Oliveira de Sá - [90%] Adversarial Tracking: Attacks on Image Sensors for Object Tracking in Autonomous Vehicles
Han Wu; Alex Chan; Ekin Can Erkus; Tousif Rahman; Rishad Shafik - [90%] Cracks in Embeddings: Robustness and Stability of JEPA-Based Chest X-Ray Representations
Zahid Mansur; Kalpana Yadav; Deepak Mishra - [89%] SNAPRAG: Cost-Efficient Knowledge Extraction Attack on RAG Systems via Adversarial Perturbations
Melih CoÅÄun; Mehmet Emre Gürsoy; Alptekin Küpçü; Sinem Sav - [89%] Beyond Attack-Based Accuracy: Rethinking Adversarial Robustness Evaluation Through Structural Gradient Alignment
Hanrui Wang; Yu Luo; Shuo Wang; Xingbo Dong; Zhe Jin; Isao Echizen - [89%] SCR: Detecting Backdoor-Poisoned Samples through Clean-Reference Residuals
Yi Yang; Jinyang Huang; Feng-Qi Cui; Yu-Tong Guo; Sirui Zhao; Haiming Jin; Weihua Li; Quan Bai; Meng Li - [86%] Adversarial Robustness of Retrieval-Based Fact-Checking: Detecting and Mitigating Evidence Contamination
Alamgir Munir Qazi; John P. McCrae; Jamal Abdul Nasir - [84%] Adversarial robustness does not entail human-aligned categorization
Itay Reznik; Raz Lapid; Moshe Sipper; Tal Golan - [84%] Procedural Adversarial Learning
Jack Nugent; Jia Deng - [84%] Adversarial Risk in the Generative AI Era Necessitates Dropping the Small Epsilon Ball
Andrew C. Cullen; Neil G. Marchant; Paul Montague; Jiani Xie; Benjamin I. P. Rubinstein - [82%] Causal AI-Driven Secure mmWave Beam Alignment with Defensive Variational Autoencoders
Nasir Khan; Asmaa Abdallah; Abdulkadir Celik; Ahmed M. Eltawil; Sinem Coleri; Cicek Cavdar - [81%] Evolutionary-based Transfer Learning for Physical Attack on End-to-End Autoencoder Communications
Ho Viet Duc Luong; Lang Hong Nguyet Anh; Huynh Thi Thanh Binh; Trinh Van Chien - [81%] RECLAIM: Robot-Vision-Informed Adversarial Patch Defense via Embodied Attention Feedback
Jiayou Zhu; Peng Guo; Litian Zhang; Xinze Shi; Yuting Zhang; Zelong Yu; Yize Tian; Jirong Liu; Zifeng Kang - [80%] The Blind Spots of Detection: Adversarial Perturbation Attacks against Watchdogs in Distributed LLM Inference
Siu Wai Shi; Xiaochen Zhu; Xinjian Luo; Keke Huang; Bingxue Zhang; Xiaofeng Gao - [80%] Towards Fine-grained and Robust Detection of Human-AI Co-authorship
Ziruo Zhao; Jie Fu; Wendy Hui Wang; Zining Zhu - [80%] JevBreak: Your Model, Their Decision
Nitin Aravind Birur; Divyanshu Kumar; Sahil Agarwal; Prashanth Harshangi - [80%] Robustness Verification against Patch Attacks via Group-Lasso Semidefinite Relaxation
Yukina Nakagawa; Takami Sato; Ken Kobayashi; Kazuhide Nakata - [80%] Catastrophic Overfitting is Weight Drift the Training Loss Cannot See
Chao Pan - [80%] A Bag of Tricks for Defending Deep Learning-based Face Recognition Pipelines against Backdoor Attacks
Quentin Le Roux; Marti Jimenez; Yannick Teglia; Philippe Loubet Moundi - [80%] Scaling Adaptive Prompt Injection Attacks with Agent Swarms
Alexey Kurakin; Vishal Karande; Alex Bie; Chongyang Shi; Shuang Song; Saeed Mahloujifar; Abdullatif Köksal; Jamie Hayes; Juliette Pluto; Yinghao Sun; Kamalika Chaudhuri - [80%] GPromptShield: Elevating Resilience in Graph Prompt Tuning against Adversarial Attacks
Shuhan Song; Ping Li; Ming Dun; Maolei Huang; Huawei Cao; Xiaochun Ye - [80%] DACE: Diversity-Driven Adversarial Co-Evolution for Robust LLM Safety Alignment
Peng Yu; Xiaoyu Wen; Zhida He; Ziyuan Zhou; Han Qi; Shao Zhang; Qiaosheng Zhang; Ying Wen; Chaochao Lu - [79%] Addition by Subtraction: Toward Mitigating Fragile Safety Alignment in Large Language Models
Hamid Dashtbani; Alexandra Dmitrienko - [79%] Speech Tokenizers are Vulnerable: Transferable Semantic Attack and Robust Tokenizer
Zhisheng Zhang; Yifan Mi; Yixuan Zhou; Haiyun Li; Shengbo Cai; Dongfu Song; Ziang Xu; Jie Hao; Zhiyong Wu - [78%] ScrambleMark: Zero-Query Watermark-Agnostic Black-Box Evasion of Modern Speech Watermarking
Binhao Ma; Weikang Ding; Hanqing Guo; Wenwei Zhao; Xiaowen Li; Leah Ding; Zhuo Lu; Rui Duan - [77%] AutoPI: Taxonomy-Guided Adaptive Red Teaming for Prompt Injection in LLM Agents
Stavros Damianakis; Konstantinos Psounis - [76%] HideOut – User Protection Against Localization with Throughput Guarantees in Mobile Networks
Navidreza Asadi; Michele Guardiani; Wolfgang Kellerer; Jafar Aco Mohammadi - [76%] Beyond Instruction Override: Benchmarking Indirect Prompt Injection with Task-Tampering Attacks
Rongting Zhang; Martin Bertran; Sandeep Avula; Chia-Jung Lee; Vanessa Murdock - [76%] Attacking Slide Puzzle CAPTCHAs Based on Time and Space Generative Adversarial Networks
Rui Guo; Xuelian Xie; Botao Xu; Kesheng Liu; Wenxian Wang; Haizhou Wang - [76%] FocusBranch: Combinatorial Branch-and-Bound for $\ell_0$ Neural Network Robustness Verification
Renwei Deng; Yang He; Linyi Li; Yuepeng Wang - [76%] BadGCL: Towards Persistent Backdoor Attack on Graph Continual Learning Systems
Dong Li; Yufei Han; Xintao Wu; Xujiang Zhao; Wei Cheng; Chen Zhao - [75%] The Web Doesn't Sit Still: Adversarial Self-Evolving Attacks on Search Agents
Geyuan Wang; Shunyu Liu; Siyuan Liang; Chenyang Lyu; Dacheng Tao - [74%] The Devil is in the Context: Nine Dimensions of Prompt Injection Attacks
Jiamin Chang; Kristina NikoliÄ; Rishi Sharma; Giovanni Cherubin; Vasilios Mavroudis; Jose Sanchez Vicarte; Arnav Garg; Hammond Pearce; Andrew Paverd; Ahmed Salem - [74%] BrainwashedLLM: Jailbreaking via Automated Adversarial Chain of Thoughts Discovery
Masoud Poorghaffar Aghdam; GöktuÄ Serdar Yıldırım; Sinem Sav - [74%] RLGPA: A Reinforcement Learning-Guided Granularity Planning Attack for Decision-Based Sparse Adversarial Examples
Chao Zhou; Shenghua He; Jiaxin Mo; Qiangguo Yu; Fengchuang Xing - [74%] Should We Pay This Much for Robustness? Efficient Proxy Certificates with Marginal Guarantees
Soroush H. Zargarbashi; Mohammad Sadegh Akhondzadeh; Aleksandar Bojchevski - [73%] Dressed in Authority: Practical Black-Box Jailbreaking of MLLMs via Visual Trust Bias
Weihang Liu; Qianqian Xu; Yangbangyan Jiang; Zitai Wang; Zhipeng Yu; Qingming Huang - [72%] Systematic Evaluation of Robustness in Fine-tuned Models
Angela John; Hamayoon Behmanush - [72%] STA: A Split Temporal Adversary Method for Evaluating Robustness of Multimodal RL-based Driving Policies
Shenghao Xiong; Xiaolin Chang - [71%] Beyond $L_\infty$-Norm Sets: Synthesizing Interpretable Non-Uniform Uncertainty Sets for Evaluation-Time State-Adversarial Robustness
Xulin Chen; Ruipeng Liu; Garrett E. Katz - [71%] Model Annealing: Data-Efficient Learning through Review and Consolidation
Ali Mohammadi Ruzbahani; Rezvan Abouzadeh - [70%] Zero-Query Transferable Pretend Benign Attacks with Amortized Online Generation for Cooperative Perception
Hongwei Lin; Xun Huang; Chenglu Wen; Cheng Wang - [69%] GuardrailAgent: An Agentic Framework for Jailbreak Defense
Tianze Chang; Junjie Chu; Yixin Wu; Michael Backes; Yang Zhang - [68%] Certifying Graph Neural Networks Against Label and Structure Poisoning
Lukas Gosch; Xichuan Chen; Yan Scholten; Stephan Günnemann - [68%] Wrong Input, Wrong Threshold: Re-evaluating Adversarial Facial Privacy
Tunahan Parlayıcı; Erchan Aptoula; Yücel Saygın - [68%] Data Poisoning Attacks to Locally Differentially Private Triangle Counting Protocols
Tingxuan Han; Wei Tong; Zijian Wang; Sheng Zhong - [67%] When appearance and motion disagree: evaluating class–motion consistency against disguised uncrewed surface vessels
Jon Reifschneider - [67%] XposedMIA: Exploiting Explainable Artificial Intelligence (XAI) for One-Shot Membership Inference Attacks
Omar Hamdache; Serdar Kara; Kıvanç Kuzey Dikici; Abdullah ÃaÄlar Ãksüz; Anisa Halimi; Erman Ayday; Sinem Sav - [66%] Data Manipulation Attacks Against Machine Learning Integrated Cyber-Physical Systems
Soyon Choi; Scott Alfeld; Meiyi Ma - [66%] Stealthy, High-Impact False Data Injection Attacks in Smart Grid Using Physics-Constrained GAN
Md. Mainul Islam; Hasan Kurban; Abdulrahman Takiddin; Muhammad Ismail; Rachad Atat; Erchin Serpedin - [65%] Pop Goes the Verifier: Phoneme-Targeted Data Poisoning of Voice Liveness Detection
Eshaq Jamdar; Amith Kamath Belman - [65%] Location Matters: Sparse Latent-Variance Attacks for Face Privacy against Diffusion Personalization
Shuting Yang; Shuxin Li; Linyan Dai; Xinwei Zhang; Dong Huang; Renyang Liu; See-Kiong Ng - [65%] Ambiguous Examples Help, But Full Data Wins: Revisiting Dataset Cartography for Extractive Adversarial QA
Paul K. Mandal - [65%] Optimal Deep Nonparametric Regression with Uniformly Bounded Lipschitz Constants
Jiaxin Shi; Ziyuan Chen; Jian Huang; Hansheng Wang - [63%] Steering Bayesian Inference and Decisions through Data Poisoning
Roi Naveiro; William N. Caballero; Juan Maroñas - [62%] Quantum-inspired orthogonal adapters for certifiably robust medical image classification
Olga Tsurkan; Laia Domingo; Victoria Orlova; Asel Sagingalieva; Iris Zalaudek; Raffaele Dante Caposiena Caro - [61%] Propose with the Gradient, Accept with the Loss: One Hedged Attack for Pixel-Sparse Robustness
Hon Ming Yan; Chun Pong Lau - [60%] RGDM: Robust Graph Diffusion Model
Yancheng Wang; Ping Li; Dongfang Sun; Yingzhen Yang - [58%] Spoofing the Latent State: Imperceptible Goal-Image Attacks Derail Planning in LeWorldModel
Kunal Bhosikar; Nicole Meng; Charu Sharma; Yingjie Lao - [58%] Interactive Backdoor Attacks in LLM-Based Proactive Dialogue Systems
Zhiyang Xia; Yuming Shang; Xi Zhang - [58%] Bait: Mitigating Harmful Agentic Reinforcement Learning via Probing Reward Function
Tiansheng Huang; Ananth Balashankar; Virat Shejwalkar; Santosh Pande; Ling Liu - [57%] NonSense: On the (In)security of FPGA Anti-tamper Sensors
Mehmet Ali Cetin; Fatemeh Khojasteh Dana; Saleh Khalaj Monfared; Nima Seyed Aghazadeh; Maryam Saadat Safa; Shahin Tajik - [56%] CloakFEM: Agentic FEM Code Generation for Red-Teaming Computational Resource Exhaustion
Li Zheng; Simin Chen - [56%] When Backdoors Can Be Switched Off: Suppression-Aware Backdoor Attacks on Vision-Language-Action Models
Nur Afsa Syeda; Mohamed Elmahallawy - [55%] Homeopathic Learning: Diluting poisoned fine-tuning data can strengthen its effect
Matt Clarke; Jan DubiÅski; James Chua; Simon Schrodi; Owain Evans; Alex Cloud - [55%] BAPLe++: Cross-Model Transferability and Prompt-Level Defense of Backdoors in Medical Foundation Models
Ufaq Khan; Umair Nawaz; Satyajit Tourani; Awais Rauf; Fahad Shamshad; Asif Hanif; Rao Muhammad Anwer; Muhammad Haris Khan; Mohammad Yaqub - [55%] Chatter Attack: Resource Consumption Attack for Large Language Models
Yibo Miao; Yichuan Cao; Xiao-Shan Gao; Yinpeng Dong - [55%] StealthyPoison: Manipulating LLM Agent Behavior through Procedural Poisoning of Third-Party Skills
Jingfen Qiao; Rui Li; Shuaiqun Pan; Olga Gadyatskaya; Andrew Yates; Evangelos Kanoulas - [55%] Stress-Testing Sandbagging Detection Under Adaptive Attack
Bhoj Rani Soopal; Aarohi Agrawal; Josh Karthikeyan; Edward Lue Chee Lip - [54%] Step-Zero Attack: Agent Safety Before Observability
Tian Qin; Yuhang Jiang; Junzhe Chen; Lit Sin Tan; Lijie Wen - [54%] Timing is Everything: Inferring Temporal Membership in Continually Updated Models
Jie Fu; Xiangpeng Deng; Yuan Hong; Wendy Hui Wang - [54%] JailBound: FOL-Guided Jailbreak Evaluation for Exploring LLM Behavioral Boundaries
Fazong Wu; Xin Wang; Ming Yang; Zhenyong Zhang; Xiaoming Wu - [54%] EVAX: Towards a Practical, Pro-active & Adaptive Architecture for High Performance & Security
Samira Mirbagher Ajorpaz; Daniel Moghimi; Jeffrey Neal Collins; Gilles Pokam; Nael Abu-Ghazaleh; Dean Tullsen - [54%] When the Spec Sheet Lies: Injection Attacks on LLM-Generated Compliance Artifacts
Adriana Watson; Marco Bücheler; Grant Richards - [54%] Who Pays for Byzantine Robustness? Validity, Data-Share Dictatorships, and Fairness When Only a Few Hospitals Collaborate
Adnan Malkani - [53%] Understanding Backdoor Attacks in Scene Graph Generation via Global Context Pathway
Xiaoguang Chang; Tuo Chen; Chengze Jiang; Teng Wang; Changyin Sun - [53%] I Think, Therefore I Attack: Evaluating Thought Injection Attacks on Reasoning Agents
Parth Illendula; Garik Livingston; Zain Shamsi; Ravi Srinivasan; Alex Liu - [53%] Securing Multi-Agent Systems by Design
Xilong Wang; Xiaoxing Chen; Neil Gong - [53%] Memory Safety Isn't All You Need: Code Reuse Attacks in Memory Safe Languages
Eric Cornelissen; Musard Balliu - [53%] How Many Training Labels Are Wrong? Auditing a Fitted Model through Gradient Allocation
Yuchen Li; Zongqi Fan; Xintong Li; Nguyen H. Tran; Ken-Tye Yong - [53%] MetaScanner: An Empirical Study and Proactive Defense against Deceptive UI Attacks in Social VR
Junhee Lee; Seungwon Woo; Minseok Kim; Jongseop Kim; Kiyoung Kim; Hwanjo Heo; Jinwoo Kim - [52%] Debate to Deceive: Poisoning LLM's Fact-Checking via Game-Theoretic Multi-Agent Debate
Liting Huang; Huizhi Liang; Yi Lei; Xingjun Ma; Varun Ojha - [52%] HalluProbe: Exploiting VLM Hallucinations for Backdoor Detection
Ji Guo; Xiaolong Qin; Jin Jiang; Yijing Liu; Pei Ke; Aiguo Chen; Wenbo Jiang - [52%] SteerTrace: Tracing How Target Attacks Steer World Action Models
Yukun Dai; Tianshi Wang; Fengling Li; Jingjing Li; Xin Li; Lei Zhu - [51%] Fundamentals for Binary Classification Under Label Noise
Dimitrios I. Diochnos - [51%] DMT-Attack: Diffusion-Prior Texture Search for Closed-Loop Vision-Language-Action Policies
Jun Xia; Shangwen Wang; Jun Ma; Ruichao Ren; Zhouyang Jia; Xin Zhao; Huijun Liu; Jie Yu - [51%] ChronoPatch: Black-Box Energy-Latency Attacks on Vision-Language Models
Jiawei Xing; Li Wang; Xiangtao Meng; Chuanchao Zang; Rui Wen; Zheng Li - [50%] The Long Con on the Web: Earn-then-Exploit Fraud Attacks against Coding Agents
Xingling Xu; Zhengwei Jiang; Zheng Zhi; Fangming Dong; LingJia Guo; Wei Dong; Chunyan Ma; Jun Jiang - [50%] Beyond Prompt Injection: The Tool Update Gap in LLM Agent Security
Shiyu Kan; Yue Qi; Yufei Han; Xinjian Luo; Guojun Xiong; Xiaofeng Gao - [50%] Say the Same, Act Differently: Diagnosing and Steering Text-Action Divergence in Reasoning VLAs
Zihao Feng; Qingzhao Zhang; Chunyu Xia; Bo Yu; Z. Morley Mao; Ramesh Govindan - [50%] ConfGuard: a physics-grounded reference monitor for predictive-maintenance large-language-model agents
Arunkumar V; Gangadharan G. R.; S. Senthilkumar - [50%] The geometry of neural network decision boundaries
Dylan M Paiton; David L Schultheiss; Matthias Kümmerer; Zac Cranko; Matthias Bethge - [49%] J-Anchor: Defending Against Prefill Attacks via J-Space Selective Refusal Restoration
Running Yang; Beidi Zhao; Xiaoxiao Li - [49%] Robustness Within a Fairness Budget: Parity Frontiers and Equal-Opportunity Reversal
Pablo Rivas; Jeremy Frank - [49%] Attacker Diversity Reduction in Adaptive LLM Red Teaming
Chris Tava - [48%] Smoothing and Learning for Movement-Robust RSS-Based Spoofing Detection
Usama Mir - [47%] TERM: Target-Free Jailbreak Defense via Entropy-Guided Residual Modulation
Yunkai Dang; Wanyu Zhang; Meiyi Zhu; Qi Fan; Tianyu Ding; Wenbin Li - [47%] A Convex-Analytic Reformulation for Poisoning Attacks on Logistic Regression
Carina Moreira Costa; Maria Eduarda Pinheiro; Martin Schmidt - [46%] Improving Context-Shift Robustness of Convolutional Networks via Context-Regularized Cross-Entropy
Jinen Setpal; Chaoyue Liu - [46%] Multimodal-SEA: Benchmarking AI Agent Security under Multimodal Social Engineering Attacks
Zhitao He; Chi Him Zhang; Chengru Han; Yi R Fung - [46%] When Experience Becomes a Backdoor: Poisoning Self-Evolving LLM Agents via Failure-Aware Task Optimization
Minhua Lin; Zongyu Wu; Hanqing Lu; Xianfeng Tang; Xiang Zhang; Qi He; Suhang Wang - [46%] One Fabrication Is Enough: A Fake News Article Changes the Forecasts of LLM Forecasting Systems
Zeyu Zhang; Bradly C. Stadie - [45%] Attack Injection to Vehicle Reactions: Extensible Closed-Loop Adversarial Evaluation Framework
Mohamed Gaber; Tahsin Wahid; Mohammad Mamun; Salimur Choudhury - [45%] Lipschitz-Controlled Flow Matching for Robust Image Restoration
Sedjro Salomon Hotegni; Konstantin Sonntag; Paul-Christian Bürkner; Sebastian Peitz - [45%] Security of Deep Research Agents: Attack Surface, Defenses, Benchmarks, and Agenda Seeding against Research Planning
Yang Luo; Guangpu Chen; Yichen Liu; Zhaoyu Chen; Yifeng Gao; Zhiyang Ding; Qingni Shen; Zhonghai Wu - [44%] ErosionBench: Probing Alignment Decay in Enterprise Multi-Agent Systems
Riya Bharathwaj; Akshara Prabhakar; Roshan Ram; Avni Kothari; Sarah Tan; Huan Wang; Silvio Savarese - [44%] Domain-Adversarial Adaptation from MURA to In-House Radiographs for Improved Adult Elbow Fracture Classification
M. Bolhassani; W. Furtado; D. Duvall; MJ Negahdar; J. Joshi; S. Contractor; A. Amini - [44%] Data-Efficient Unlearning-Based Backdoor Detection in Federated Learning
Dowon Kim; Junhao Cai; Sung Il Choi; Dohun Kim; Juhyun Park; Chengjun Jin; Changhee Joo - [43%] Context-Shielded Backdoor Attack against Large Vision-Language Models
Zhifang Zhang; Qiang Huang; Chenpeng Wang; Weitong Chen; Olaf Maennel; Wei Emma Zhang; Lei Feng; Lei Zhang; Miao Xu - [43%] ATrust: Adaptive Trust Boundary Expansion for Securing LLM Agents
Xu Zhang; Zhichao Lu - [43%] Adversarially Attacking Symbolic Vocabulary Vulnerabilities In LLM Planners
Stephen Obadinma; Xiaodan Zhu - [43%] A Rank-One Bypass of Fixed Linear Erasure
Jai Kumar Sharma; Vanshaj Khattar - [43%] UniReFP: Robust Unified Fingerprinting for Vision Models against Cross-Task Repurposing Attacks
Ziye Geng; Guang Yang; Yihang Chen; Lingfeng Yao; Xing Shi; Miao Pan; Xin Fu; Changqing Luo - [42%] Right Tool, Wrong Parameters: Defending LLM Agents Against Parameter Poisoning
Yao Wang; Zehua Ma; Weiming Zhang; Han Fang - [42%] Toward a theory of Evaluability
Kunal Talwar - [42%] Scale-Induced Semantic Shift in Visual Prompt Injection Against VLMs and Web Agents
Yiheng Zhao; Runze Ji; Chenyu Yi; Yi Yu; Bingquan Shen; Alex Kot; Xudong Jiang - [42%] Sequential Semantic-Non-Semantic Watermarking: Robustness Against UnMarker Attacks
Md Ifraham Iqbal - [42%] Experience: ENTRAP – An IaC Enterprise Cyber Range for Reproducible Security Assessment and Dataset Generation
Rathan Appana; Aditya Kulkarni; Bheemarjuna Reddy Tamma - [41%] Threat Modeling Intimate Partner Abuse in Agentic Systems
Natalie Grace Brigham; Eugene Bagdasarian; Franziska Roesner; Tadayoshi Kohno - [41%] MemHarmBench: Evaluating Cross-Session Prompt Injection in Memory-Persistent AI Agents
Zhihua Wang; Yunhao Feng; Yifeng Gao; Rui Pan; Baiheng Zhao; Zixing Chen; Xingjun Ma - [41%] The Pen is Mightier than the Pixel: Natural Textual Unlearnable Example for Large Vision Language Models
Chenyu Yi; Jiawen Zong; Sami Hormi; Bingquan Shen; Xudong Jiang; Alex Chichung Kot - [41%] RAD-TFM: Robust and Domain-Adapted Tabular Foundation Models
Matthew Peroni; Franck Le; Vadim Sheinin - [41%] MGE: A Membership Guided Data Extraction Attack against Diffusion Models
Yuchang Mei; Longqiang Wang; Haoyang Jiang; Mingyang Yi; Shaolei Zhang; Keman Huang; Wuqiong Pan; Ju Fan - [40%] UniGADD: Universal Generator-Agnostic Deepfake Detector
Bernard Tomczyk; Agil Aghasanli; Plamen Angelov - [40%] PrivMark: Pixel-Space Steering against Privacy Leakage in Vision-Language Models
Ruofan Xing; Arman Akbari; Weikai Lin; Yuhao Zhu; Xuan Zhang - [40%] MUTE: Multi-Level Alignment Uncoupling Against Talking-Head Exploitation for Voice Protection
Donghyun Kim; Jin Hong; Seungmin Kim; Dain Kim; Junseok Kwon; Daeseon Choi - [40%] POEM: Output-Relative Block-Sparse Attention for Long-Context Prefilling
Haoyi Wu; Yunkai Dang; Wanyu Zhang; Lei Wang; Wenbin Li - [40%] GuardAgent: A Memory-Augmented Agentic Framework for Adaptive Detection of Adversarial Promotions in LLM-Based Recommendation
Shiyi Yang; Xinshu Li; Chen Wang; Xiwei Xu; Liming Zhu; Lina Yao - [40%] What Survives the Shift from Text to Pixels? Conditional Protection against Prompt Injection in Image-Rendered Documents
Haoyang Liu; Yinong Xu; Zhe Lang; Zhenyu Guan; Qianyun Zhang