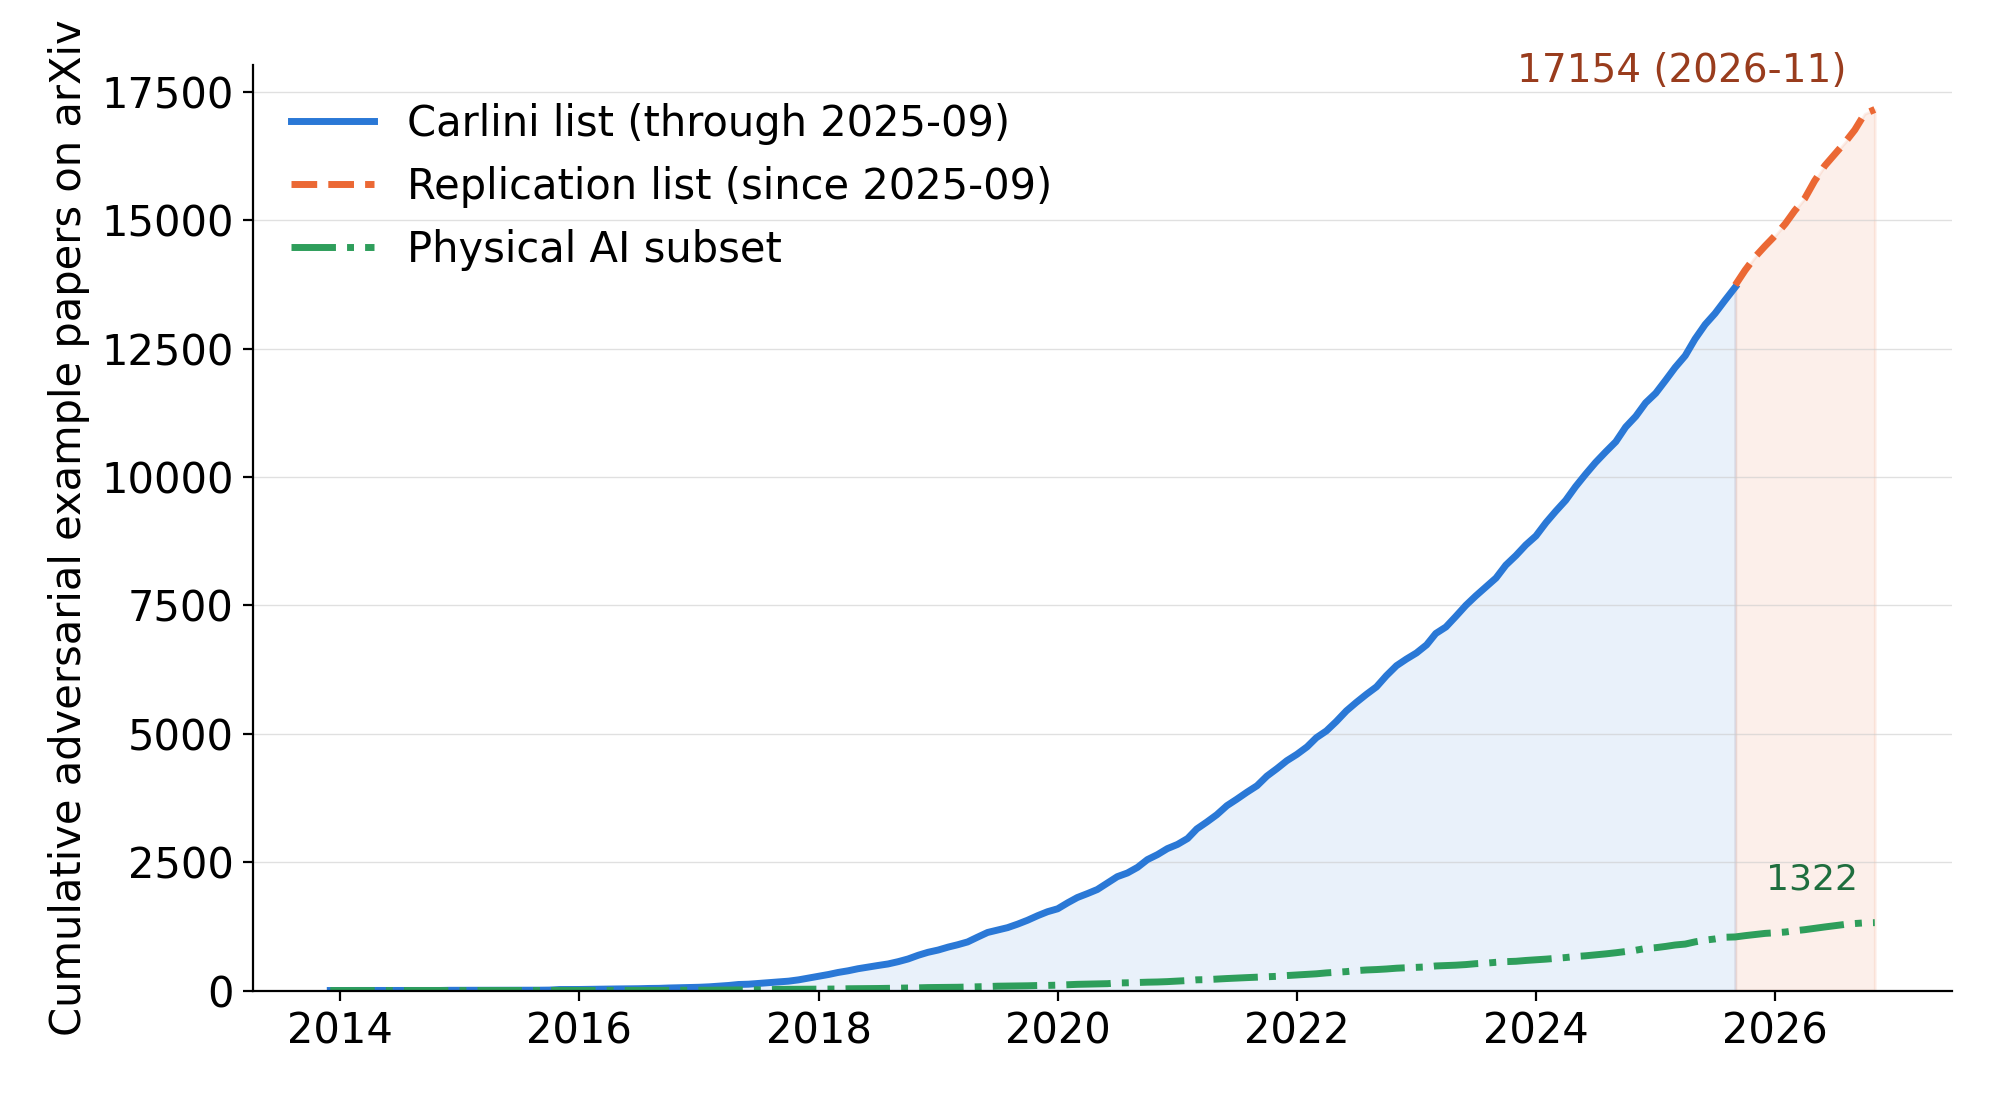
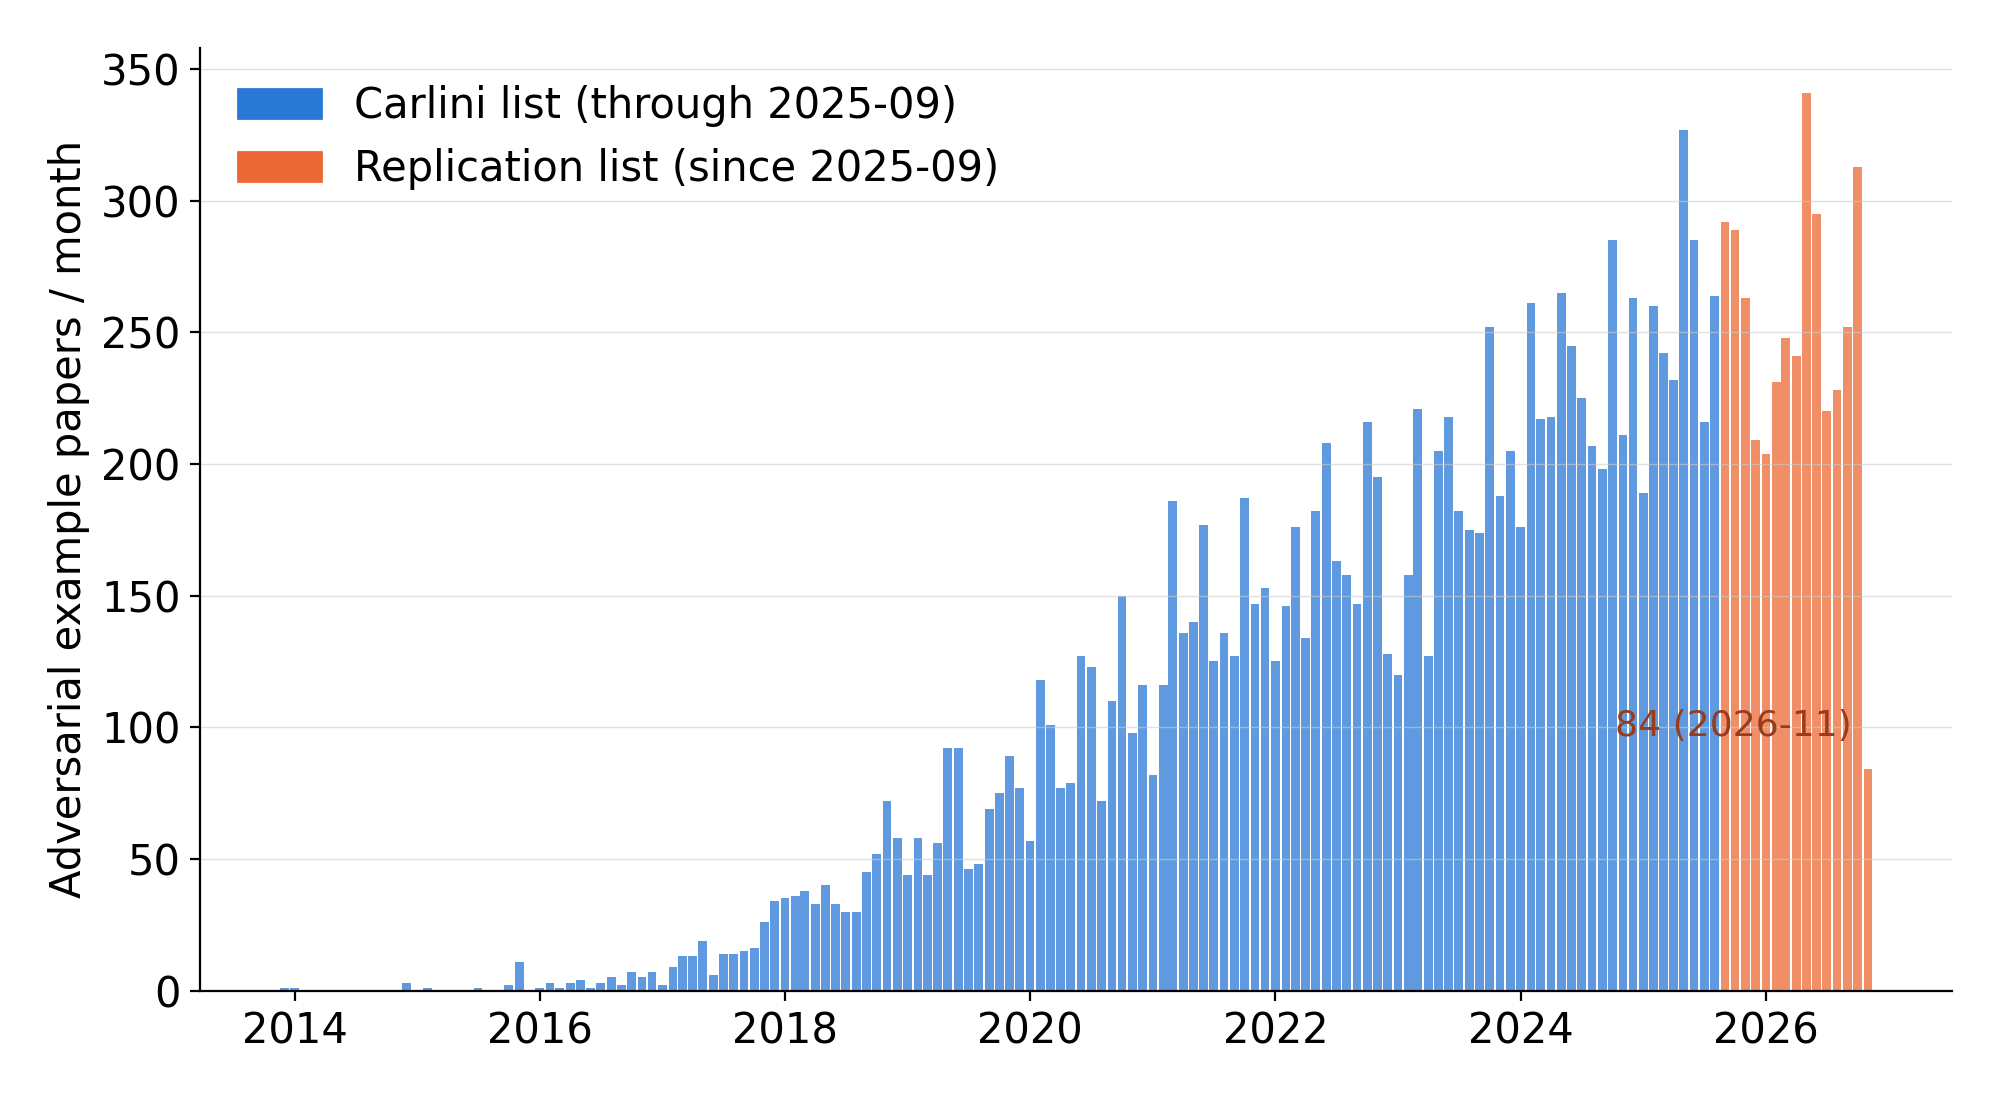
Nicholas Carlini による敵対的サンプル論文リストの継続版です。2025-09-15 以降に arXiv に投稿された論文を対象としています。元のリスト(13,697 件)で学習した TF-IDF + ロジスティック回帰の分類器(ホールドアウト AUC 0.998)でスコアが 40% 以上の論文を掲載し、arXiv ID の年月ごとにまとめています。
総数: 3477 件
最終更新: 2026-11-11.
直近1か月
2026-11(84 件)
- [100%] Black-Box Adversarial Example Attacks on Machine Learning based Election Systems
Subek Acharya; Syed Ayon; Khaleque Md Aashiq Kamal; Alina Barnett; Surya Eada; Kaleel Mahmood - [100%] Adversarial Robustness of Kernel Machines: A Comprehensive Analysis
Rahul Kumar Yadav; Tunir Ghosh; Sudhendu Ahir; Parthe Pandit; Arjun Bhagoji - [99%] VIPA: View-Invariant Projector-Based Adversarial Attack
Jiyu Han; Qingyue Deng; Bingyao Huang - [98%] GARD: Gradient-Guided Adversarial Representation Defense against Backdoors in Multimodal Contrastive Learning Models
Yuhong Wang; Yujun Cai; Lei Feng; Songze Li - [97%] Structured Confidence Perturbation via Fisher Geometry for Adversarial Training
Chenlong Wei; Hanling Wang; Chong Zhang; Qinkai Yu; Fangyu Wu; Xiaobo Jin - [96%] Anchored Rank-Adversarial Fine-Tuning Pretrained Visual Place Recognition Models
Mostafa Kira; Bader Rasheed; Manuel Mazzara - [96%] On Lipschitz Explosion in Deep Neural Networks with Normalization: Consequences for Optimization and Adversarial Robustness
Ashkan Soleymani; Reyhaneh Hosseinpourkhoshkbari; Hadi Daneshmand; Patrick Jaillet - [95%] RL-ATTACK: A Generalized Black-Box Adversarial Attack on Language Models via Reinforcement Learning
Taikun Chen; Yue Zhang; Wei Qian; Hui Fang - [93%] Robust Deep Prototype Classifiers via Lipschitz Training
Adia Khalid Khan; Lukas Gehring; Benjamin PaaÃen - [93%] AnyBreak: Towards Jailbreaking Any T2I Model for Any Concept
Qi Lu; Zehui Guo; Yucheng Zhao; Zijing Li; Chuhan Song; Wenrui Zhu - [91%] Adversarial Robustness Is Not Zero-Day Generalization: A Controlled Evaluation of Flow-Based Intrusion Detectors on Corrected CIC-IDS2017
Abdulhamid Zaro - [89%] SNAPRAG: Cost-Efficient Knowledge Extraction Attack on RAG Systems via Adversarial Perturbations
Melih CoÅÄun; Mehmet Emre Gürsoy; Alptekin Küpçü; Sinem Sav - [86%] Adversarial Robustness of Retrieval-Based Fact-Checking: Detecting and Mitigating Evidence Contamination
Alamgir Munir Qazi; John P. McCrae; Jamal Abdul Nasir - [84%] Adversarial robustness does not entail human-aligned categorization
Itay Reznik; Raz Lapid; Moshe Sipper; Tal Golan - [84%] Procedural Adversarial Learning
Jack Nugent; Jia Deng - [80%] The Blind Spots of Detection: Adversarial Perturbation Attacks against Watchdogs in Distributed LLM Inference
Siu Wai Shi; Xiaochen Zhu; Xinjian Luo; Keke Huang; Bingxue Zhang; Xiaofeng Gao - [80%] Towards Fine-grained and Robust Detection of Human-AI Co-authorship
Ziruo Zhao; Jie Fu; Wendy Hui Wang; Zining Zhu - [80%] JevBreak: Your Model, Their Decision
Nitin Aravind Birur; Divyanshu Kumar; Sahil Agarwal; Prashanth Harshangi - [80%] Robustness Verification against Patch Attacks via Group-Lasso Semidefinite Relaxation
Yukina Nakagawa; Takami Sato; Ken Kobayashi; Kazuhide Nakata - [80%] Catastrophic Overfitting is Weight Drift the Training Loss Cannot See
Chao Pan - [80%] A Bag of Tricks for Defending Deep Learning-based Face Recognition Pipelines against Backdoor Attacks
Quentin Le Roux; Marti Jimenez; Yannick Teglia; Philippe Loubet Moundi - [80%] Scaling Adaptive Prompt Injection Attacks with Agent Swarms
Alexey Kurakin; Vishal Karande; Alex Bie; Chongyang Shi; Shuang Song; Saeed Mahloujifar; Abdullatif Köksal; Jamie Hayes; Juliette Pluto; Yinghao Sun; Kamalika Chaudhuri - [79%] Addition by Subtraction: Toward Mitigating Fragile Safety Alignment in Large Language Models
Hamid Dashtbani; Alexandra Dmitrienko - [78%] ScrambleMark: Zero-Query Watermark-Agnostic Black-Box Evasion of Modern Speech Watermarking
Binhao Ma; Weikang Ding; Hanqing Guo; Wenwei Zhao; Xiaowen Li; Leah Ding; Zhuo Lu; Rui Duan - [76%] HideOut – User Protection Against Localization with Throughput Guarantees in Mobile Networks
Navidreza Asadi; Michele Guardiani; Wolfgang Kellerer; Jafar Aco Mohammadi - [76%] Beyond Instruction Override: Benchmarking Indirect Prompt Injection with Task-Tampering Attacks
Rongting Zhang; Martin Bertran; Sandeep Avula; Chia-Jung Lee; Vanessa Murdock - [76%] Attacking Slide Puzzle CAPTCHAs Based on Time and Space Generative Adversarial Networks
Rui Guo; Xuelian Xie; Botao Xu; Kesheng Liu; Wenxian Wang; Haizhou Wang - [76%] FocusBranch: Combinatorial Branch-and-Bound for $\ell_0$ Neural Network Robustness Verification
Renwei Deng; Yang He; Linyi Li; Yuepeng Wang - [75%] The Web Doesn't Sit Still: Adversarial Self-Evolving Attacks on Search Agents
Geyuan Wang; Shunyu Liu; Siyuan Liang; Chenyang Lyu; Dacheng Tao - [74%] The Devil is in the Context: Nine Dimensions of Prompt Injection Attacks
Jiamin Chang; Kristina NikoliÄ; Rishi Sharma; Giovanni Cherubin; Vasilios Mavroudis; Jose Sanchez Vicarte; Arnav Garg; Hammond Pearce; Andrew Paverd; Ahmed Salem - [74%] BrainwashedLLM: Jailbreaking via Automated Adversarial Chain of Thoughts Discovery
Masoud Poorghaffar Aghdam; GöktuÄ Serdar Yıldırım; Sinem Sav - [74%] RLGPA: A Reinforcement Learning-Guided Granularity Planning Attack for Decision-Based Sparse Adversarial Examples
Chao Zhou; Shenghua He; Jiaxin Mo; Qiangguo Yu; Fengchuang Xing - [74%] Should We Pay This Much for Robustness? Efficient Proxy Certificates with Marginal Guarantees
Soroush H. Zargarbashi; Mohammad Sadegh Akhondzadeh; Aleksandar Bojchevski - [72%] Systematic Evaluation of Robustness in Fine-tuned Models
Angela John; Hamayoon Behmanush - [71%] Beyond $L_\infty$-Norm Sets: Synthesizing Interpretable Non-Uniform Uncertainty Sets for Evaluation-Time State-Adversarial Robustness
Xulin Chen; Ruipeng Liu; Garrett E. Katz - [70%] Zero-Query Transferable Pretend Benign Attacks with Amortized Online Generation for Cooperative Perception
Hongwei Lin; Xun Huang; Chenglu Wen; Cheng Wang - [69%] GuardrailAgent: An Agentic Framework for Jailbreak Defense
Tianze Chang; Junjie Chu; Yixin Wu; Michael Backes; Yang Zhang - [68%] Certifying Graph Neural Networks Against Label and Structure Poisoning
Lukas Gosch; Xichuan Chen; Yan Scholten; Stephan Günnemann - [67%] When appearance and motion disagree: evaluating class–motion consistency against disguised uncrewed surface vessels
Jon Reifschneider - [67%] XposedMIA: Exploiting Explainable Artificial Intelligence (XAI) for One-Shot Membership Inference Attacks
Omar Hamdache; Serdar Kara; Kıvanç Kuzey Dikici; Abdullah ÃaÄlar Ãksüz; Anisa Halimi; Erman Ayday; Sinem Sav - [66%] Data Manipulation Attacks Against Machine Learning Integrated Cyber-Physical Systems
Soyon Choi; Scott Alfeld; Meiyi Ma - [65%] Pop Goes the Verifier: Phoneme-Targeted Data Poisoning of Voice Liveness Detection
Eshaq Jamdar; Amith Kamath Belman - [65%] Location Matters: Sparse Latent-Variance Attacks for Face Privacy against Diffusion Personalization
Shuting Yang; Shuxin Li; Linyan Dai; Xinwei Zhang; Dong Huang; Renyang Liu; See-Kiong Ng - [60%] RGDM: Robust Graph Diffusion Model
Yancheng Wang; Ping Li; Dongfang Sun; Yingzhen Yang - [58%] Spoofing the Latent State: Imperceptible Goal-Image Attacks Derail Planning in LeWorldModel
Kunal Bhosikar; Nicole Meng; Charu Sharma; Yingjie Lao - [58%] Interactive Backdoor Attacks in LLM-Based Proactive Dialogue Systems
Zhiyang Xia; Yuming Shang; Xi Zhang - [56%] CloakFEM: Agentic FEM Code Generation for Red-Teaming Computational Resource Exhaustion
Li Zheng; Simin Chen - [55%] Homeopathic Learning: Diluting poisoned fine-tuning data can strengthen its effect
Matt Clarke; Jan DubiÅski; James Chua; Simon Schrodi; Owain Evans; Alex Cloud - [55%] BAPLe++: Cross-Model Transferability and Prompt-Level Defense of Backdoors in Medical Foundation Models
Ufaq Khan; Umair Nawaz; Satyajit Tourani; Awais Rauf; Fahad Shamshad; Asif Hanif; Rao Muhammad Anwer; Muhammad Haris Khan; Mohammad Yaqub - [55%] Chatter Attack: Resource Consumption Attack for Large Language Models
Yibo Miao; Yichuan Cao; Xiao-Shan Gao; Yinpeng Dong - [55%] StealthyPoison: Manipulating LLM Agent Behavior through Procedural Poisoning of Third-Party Skills
Jingfen Qiao; Rui Li; Shuaiqun Pan; Olga Gadyatskaya; Andrew Yates; Evangelos Kanoulas - [54%] Step-Zero Attack: Agent Safety Before Observability
Tian Qin; Yuhang Jiang; Junzhe Chen; Lit Sin Tan; Lijie Wen - [54%] Timing is Everything: Inferring Temporal Membership in Continually Updated Models
Jie Fu; Xiangpeng Deng; Yuan Hong; Wendy Hui Wang - [54%] JailBound: FOL-Guided Jailbreak Evaluation for Exploring LLM Behavioral Boundaries
Fazong Wu; Xin Wang; Ming Yang; Zhenyong Zhang; Xiaoming Wu - [54%] EVAX: Towards a Practical, Pro-active & Adaptive Architecture for High Performance & Security
Samira Mirbagher Ajorpaz; Daniel Moghimi; Jeffrey Neal Collins; Gilles Pokam; Nael Abu-Ghazaleh; Dean Tullsen - [53%] Understanding Backdoor Attacks in Scene Graph Generation via Global Context Pathway
Xiaoguang Chang; Tuo Chen; Chengze Jiang; Teng Wang; Changyin Sun - [53%] I Think, Therefore I Attack: Evaluating Thought Injection Attacks on Reasoning Agents
Parth Illendula; Garik Livingston; Zain Shamsi; Ravi Srinivasan; Alex Liu - [52%] Debate to Deceive: Poisoning LLM's Fact-Checking via Game-Theoretic Multi-Agent Debate
Liting Huang; Huizhi Liang; Yi Lei; Xingjun Ma; Varun Ojha - [50%] The Long Con on the Web: Earn-then-Exploit Fraud Attacks against Coding Agents
Xingling Xu; Zhengwei Jiang; Zheng Zhi; Fangming Dong; LingJia Guo; Wei Dong; Chunyan Ma; Jun Jiang - [50%] Beyond Prompt Injection: The Tool Update Gap in LLM Agent Security
Shiyu Kan; Yue Qi; Yufei Han; Xinjian Luo; Guojun Xiong; Xiaofeng Gao - [50%] Say the Same, Act Differently: Diagnosing and Steering Text-Action Divergence in Reasoning VLAs
Zihao Feng; Qingzhao Zhang; Chunyu Xia; Bo Yu; Z. Morley Mao; Ramesh Govindan - [49%] J-Anchor: Defending Against Prefill Attacks via J-Space Selective Refusal Restoration
Running Yang; Beidi Zhao; Xiaoxiao Li - [47%] TERM: Target-Free Jailbreak Defense via Entropy-Guided Residual Modulation
Yunkai Dang; Wanyu Zhang; Meiyi Zhu; Qi Fan; Tianyu Ding; Wenbin Li - [46%] Improving Context-Shift Robustness of Convolutional Networks via Context-Regularized Cross-Entropy
Jinen Setpal; Chaoyue Liu - [46%] Multimodal-SEA: Benchmarking AI Agent Security under Multimodal Social Engineering Attacks
Zhitao He; Chi Him Zhang; Chengru Han; Yi R Fung - [46%] When Experience Becomes a Backdoor: Poisoning Self-Evolving LLM Agents via Failure-Aware Task Optimization
Minhua Lin; Zongyu Wu; Hanqing Lu; Xianfeng Tang; Xiang Zhang; Qi He; Suhang Wang - [45%] Attack Injection to Vehicle Reactions: Extensible Closed-Loop Adversarial Evaluation Framework
Mohamed Gaber; Tahsin Wahid; Mohammad Mamun; Salimur Choudhury - [45%] Lipschitz-Controlled Flow Matching for Robust Image Restoration
Sedjro Salomon Hotegni; Konstantin Sonntag; Paul-Christian Bürkner; Sebastian Peitz - [44%] ErosionBench: Probing Alignment Decay in Enterprise Multi-Agent Systems
Riya Bharathwaj; Akshara Prabhakar; Roshan Ram; Avni Kothari; Sarah Tan; Huan Wang; Silvio Savarese - [44%] Domain-Adversarial Adaptation from MURA to In-House Radiographs for Improved Adult Elbow Fracture Classification
M. Bolhassani; W. Furtado; D. Duvall; MJ Negahdar; J. Joshi; S. Contractor; A. Amini - [44%] Data-Efficient Unlearning-Based Backdoor Detection in Federated Learning
Dowon Kim; Junhao Cai; Sung Il Choi; Dohun Kim; Juhyun Park; Chengjun Jin; Changhee Joo - [43%] Context-Shielded Backdoor Attack against Large Vision-Language Models
Zhifang Zhang; Qiang Huang; Chenpeng Wang; Weitong Chen; Olaf Maennel; Wei Emma Zhang; Lei Feng; Lei Zhang; Miao Xu - [43%] ATrust: Adaptive Trust Boundary Expansion for Securing LLM Agents
Xu Zhang; Zhichao Lu - [42%] Right Tool, Wrong Parameters: Defending LLM Agents Against Parameter Poisoning
Yao Wang; Zehua Ma; Weiming Zhang; Han Fang - [42%] Toward a theory of Evaluability
Kunal Talwar - [41%] Threat Modeling Intimate Partner Abuse in Agentic Systems
Natalie Grace Brigham; Eugene Bagdasarian; Franziska Roesner; Tadayoshi Kohno - [41%] MemHarmBench: Evaluating Cross-Session Prompt Injection in Memory-Persistent AI Agents
Zhihua Wang; Yunhao Feng; Yifeng Gao; Rui Pan; Baiheng Zhao; Zixing Chen; Xingjun Ma - [41%] The Pen is Mightier than the Pixel: Natural Textual Unlearnable Example for Large Vision Language Models
Chenyu Yi; Jiawen Zong; Sami Hormi; Bingquan Shen; Xudong Jiang; Alex Chichung Kot - [41%] RAD-TFM: Robust and Domain-Adapted Tabular Foundation Models
Matthew Peroni; Franck Le; Vadim Sheinin - [41%] MGE: A Membership Guided Data Extraction Attack against Diffusion Models
Yuchang Mei; Longqiang Wang; Haoyang Jiang; Mingyang Yi; Shaolei Zhang; Keman Huang; Wuqiong Pan; Ju Fan - [40%] UniGADD: Universal Generator-Agnostic Deepfake Detector
Bernard Tomczyk; Agil Aghasanli; Plamen Angelov - [40%] PrivMark: Pixel-Space Steering against Privacy Leakage in Vision-Language Models
Ruofan Xing; Arman Akbari; Weikai Lin; Yuhao Zhu; Xuan Zhang - [40%] MUTE: Multi-Level Alignment Uncoupling Against Talking-Head Exploitation for Voice Protection
Donghyun Kim; Jin Hong; Seungmin Kim; Dain Kim; Junseok Kwon; Daeseon Choi - [40%] POEM: Output-Relative Block-Sparse Attention for Long-Context Prefilling
Haoyi Wu; Yunkai Dang; Wanyu Zhang; Lei Wang; Wenbin Li
→ 全リストを見る